
MLOps kompiuterinei regai: praktinis diegimo į gamybinę aplinką pavyzdys
MLOps kompiuterinei regai: nuo „Jupyter“ užrašinių iki produkcinio duomenų srauto
Kaip „Agmis“ perkėlė energetikos tinklų analizės startuolio kompiuterinės regos modelius iš „Jupyter“ užrašinių į atkuriamą „AWS SageMaker“ procesą, kuriame kiekvienas modelio mokymo paleidimas yra registruojamas, atsekamas ir pakartojamas.
Energetikos tinklų analizės inovatorius, keičiantis komunalinės infrastruktūros vertinimą
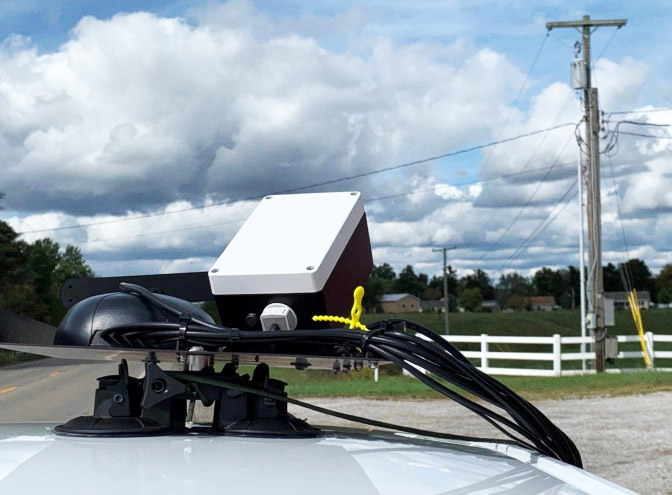
Rizikos kapitalo investicijų pritraukęs energetikos tinklų analizės startuolis, išsiskiriantis infrastruktūros vertinimo srityje. Jo sprendimas – ant transporto priemonių montuojamos autonominės DI sistemos, kurios dideliu mastu skenuoja ir vertina elektros tinklo objektus. Iki šiol jų modeliai jau įvertino daugiau nei 500 000 elektros stulpų didžiosioms JAV energetikos bendrovėms, plėsdami kompiuterinės regos galimybes infrastruktūros turto valdymo srityje.
Spartus augimas išryškino ML infrastruktūros trūkumus
Neefektyvūs modelių mokymo procesai
Modelių kūrimas daugiausia vyko „Jupyter“ užrašinėse – aplinkoje, kurioje trūko struktūros, būtinos rezultatams patikimai atkurti. Užrašinėje lieka vienoje vietoje egzistuojanti būsena: aplinka, vykdymo seka, vietiniai duomenų keliai ar dar neįrašytas išankstinio duomenų apdorojimo pakeitimas. Tokia situacija kainuoja dvejopai – tiek dėl ad hoc naudojamų skaičiavimo išteklių, tiek dėl inžinierių laiko, skiriamo atkurti, kaip buvo gautas konkretus modelis.
Duomenų valdymo spragos
Labai didelių duomenų rinkinių valdymas ir modelių diegimas dinamiškoje realioje aplinkoje nuolat kėlė iššūkių. Svarbiausia buvo paties kliento įvardyta spraga: skirtumas tarp „modelis veikia užrašinėje“ ir „modelis veikia transporto priemonėje“ didėjo su kiekviena nauja energetikos bendrove ir kiekvienu nauju infrastruktūros objekto tipu.
Stebėsenos spragos
Įdiegus modelius, jų veikimo matomumas sumažėdavo. Nebuvo patikimos sistemos, kuri sektų modelių veikimą produkcinėje aplinkoje ar parodytų, kada modelį reikia mokyti iš naujo. Todėl modelis, kurio tikslumas jau buvo suprastėjęs dėl nuokrypio, atrodė taip pat kaip tinkamai veikiantis modelis – kol kas nors to specialiai nepatikrindavo. Tokios problemos ilgainiui kaupiasi nepastebimai.
Plėtros kliūtys
Nedidelei komandai ir siaurai veiklos apimčiai pavieniai modelių mokymo paleidimai bei nesusieti procesai dar buvo valdomi. Tačiau klientui augant kiekvienas naujas pritaikymo atvejis daugino nefiksuojamų kintamųjų skaičių, o anksčiau buvę nepatogumai tapo realiu verslo plėtros greitį ribojančiu veiksniu.
Individuali MLOps strategija patikimam veikimui produkcinėje aplinkoje
Darbo tikslas buvo sukurti infrastruktūrą aplink jau veikiančius modelius, o ne kurti juos iš naujo – tuo pačiu principu grindžiamos ir mūsų mašininio mokymosi konsultacijos.
Kompiuterinės regos modelių mokymas „AWS SageMaker“: Modelių mokymas perkeltas iš „Jupyter“ užrašinių į tam skirtą „SageMaker“ infrastruktūrą. Tiesioginis rezultatas – mažesnės sąnaudos, o struktūrinis – sistemingas procesas: modelio mokymas tapo aiškiai apibrėžta operacija su nurodytais įvesties duomenimis ir užregistruotu rezultatu.
Mokymo paleidimų registravimas „Amazon Redshift“: Kiekvieno modelio mokymo paleidimo kontekstas registruojamas „Redshift“ sistemoje – modelio nustatymai, kodo versijos, duomenų rinkinio informacija, gauti rodikliai ir modelio svoriai. Informacija neprarandama ir vėliau nereikia iš atminties atkurti, kas buvo atlikta.
„Weights & Biases“ integracija: Eksperimentų stebėsenai įdiegėme ir pritaikėme „W&B“, kad komanda galėtų matyti modelių mokymo eigą bei pagrindinius rodiklius be tiesioginės prieigos prie mokymo infrastruktūros. Taip pašalinta viena dažniausių praktinių priežasčių, dėl kurių inžinieriai praleidžia tinkamą eksperimentų fiksavimą.
Modelių svoriai ir atsekamumas: Modelio svoriai registruojami kartu su kitais kiekvieno paleidimo metaduomenimis, todėl produkcinėje aplinkoje veikiantį modelį galima susieti su konkrečiu mokymo procesu, kuriame jis buvo sukurtas. Be šio ryšio įdiegti modeliai ir jų mokymo istorija ilgainiui atsiskiria.
Duomenų praktikos ir sintetiniai defektai: Perdavėme praktinę patirtį duomenų vientisumo, klaidų analizės ir defektuotų pavyzdžių sintezavimo iš geros kokybės pavyzdžių srityse. Kokybės kontrolėje defektai iš prigimties yra reti – stabilus procesas sukuria mažai broko, iš kurio modelis galėtų mokytis. Sintetiniai pavyzdžiai leidžia praplėsti mokymo duomenis nelaukiant, kol sukaupsime pakankamai realių gedimų ar defektų.
Produkcinės aplinkos sąnaudų optimizavimas: Optimizavome modelių iškvietimą produkcinėje aplinkoje. Modelių mokymo infrastruktūra yra lengvai matoma sąnaudų dalis, tačiau modelių iškvietimas produkcijoje yra nuolatinė pasikartojanti sąnauda. Ją sumažinus pasikeitė ne tik kūrimo kaštai, bet ir visos paslaugos ekonomika.
Integruotas bendradarbiavimas: Darbus pradėjome kartu su vadovų komanda – projekto vadovu, CEO ir duomenų mokslininku – o vėliau tiesiogiai įsitraukėme į ML komandos darbą. Vietoje vienkartinio platformos perdavimo sprendimus derinome užduotis po užduoties, remdamiesi modeliais, su kuriais komanda tuo metu realiai dirbo.
Gili partnerystė
Skirta nuosekliai ML infrastruktūros transformacijai nuo pagrindų – ir darbai tęsiasi
Visas procesas nuo pradžios iki pabaigos: „SageMaker“, „Redshift“ ir „Weights & Biases“
Penkios dalys, kiekviena atliekanti savo funkciją. Tai supaprastintas sukurto proceso vaizdas, o ne universali rekomenduojama architektūra, tačiau kiekvienas etapas atitinka informaciją, kurią sistema dabar registruoja.
1. Mokymo duomenys ir užduotis
Kiekvienam paleidimui naudojamas duomenų rinkinys aiškiai identifikuojamas ir užregistruojamas, o „SageMaker“ užduotyje nurodomi visi įvesties duomenys: modelio nustatymai, kodo versija ir duomenų rinkinys. Niekas nelieka paslėpta užrašinės vykdymo būsenoje.
2. Paleidimo įrašas
Užbaigus mokymo paleidimą, jo nustatymai, kodo versijos, duomenų rinkinio informacija, rodikliai ir gauti modelio svoriai įrašomi į „Redshift“. Šis įrašas tampa pagrindu trims tolesniems etapams.
3. Modelio svoriai
Modelio svoriai saugomi kartu su tuo pačiu įrašu, todėl produkcinėje aplinkoje veikiantį modelį galima atsekti iki mokymo užduoties, kurioje jis buvo sukurtas. Dėl to regresijos priežasties paieška iš ilgo tyrimo tampa aiškia duomenų užklausa.
4. Modelio iškvietimas produkcinėje aplinkoje
Inferencija vykdoma optimizuotu keliu. Modelių mokymas yra ta vieta, kur sąnaudos labiausiai matomos, tačiau jų iškvietimas produkcinėje aplinkoje yra nuolat pasikartojanti sąnaudų dalis – ir būtent ją daugelis MLOps projektų palieka neoptimizuotą.
Konkretūs rezultatai ML procesuose
Reikšmingas sąnaudų sumažinimas
Modelių mokymą perkėlus į tam skirtą infrastruktūrą sumažėjo skaičiavimo sąnaudos, o optimizavus modelių iškvietimą produkcinėje aplinkoje sumažintos ir nuolatinės veiklos išlaidos. Sutaupymas buvo reikšmingas, tačiau konkretaus skaičiaus neskelbiame, nes klientas jo neviešina.
Procesų sisteminimas
ML procesai tapo pakartojami ir audituojami. Nuo modelių mokymo iki jų stebėsenos ir valdymo visas procesas įgavo aiškią struktūrą, kuri išlieka ir leidžia kiekvieną kitą modelį kurti bei prižiūrėti efektyviau nei ankstesnį.
Žinių perdavimas
Tai nebuvo vien sprendimo perdavimas – tai buvo partnerystė. Kliento komanda perėmė naujas metodikas ir kompetencijas, sustiprindama vidinius gebėjimus, kurie išlieka ir pasibaigus mūsų bendram darbui, o ne sukuria priklausomybę nuo išorinio partnerio.
Produkcinei aplinkai parengtas procesas
Nuo eksperimentavimo užrašinėse pereita prie sistemingos MLOps praktikos, pasirengusios priimti naujas energetikos bendroves, regionus ir infrastruktūros objektų tipus, kiekvieną kartą iš naujo neperprojektuojant infrastruktūros.
Kompiuterinės regos modelių mokymo infrastruktūra „AWS SageMaker“
Perėjimas nuo pavienių eksperimentų „Jupyter“ užrašinėse prie „AWS SageMaker“ iš esmės pakeitė modelių kūrimo procesą. Anksčiau gana fragmentiški mokymo bandymai tapo struktūruotomis ir ekonomiškai efektyviomis operacijomis su aiškiai nurodytais įvesties duomenimis ir užregistruotais rezultatais.
Visiškas atkuriamumas
Visas kiekvieno modelio mokymo paleidimo kontekstas – modelio nustatymai, kodo versijos, duomenų rinkinio informacija, rodikliai ir svoriai – dabar registruojamas „Redshift“ sistemoje. Tai pašalina problemą „mano kompiuteryje veikė“ ir sukuria išsamią kiekvieno produkcinėje aplinkoje veikiančio modelio auditavimo istoriją. Kartu sukuriamas atskaitos taškas kitam etapui.
Eksperimentų matomumas realiuoju laiku
Integravus „Weights & Biases“, komandos nariai gali stebėti modelių mokymo eigą ir pagrindinius rodiklius neturėdami tiesioginės prieigos prie mokymo infrastruktūros. Toks matomumas sutrumpino iteracijų ciklus ir perkėlė modelių peržiūrą iš vieno specialisto kompiuterio į bendrą komandos darbo procesą.
Tvarūs vidiniai gebėjimai
Be įrankių ir infrastruktūros, projektas kliento komandai perdavė ir gilias ML procesų valdymo kompetencijas. Dabar komanda turi žinias, procesus ir pasitikėjimą savarankiškai toliau plėtoti savo ML praktiką – būtent toks rezultatas išlieka pasibaigus bendram projektui.
Kam šis sprendimas tinka – ir kam ne
Tinka, kai modeliai jau yra svarbi verslo dalis
Jūsų modeliai veikia ir jau naudojami komercinėje veikloje, tačiau jų pakartotinis mokymas yra sunkiai prognozuojamas, rezultatų nepavyksta atkurti arba niekas negali tiksliai pasakyti, kaip iš tiesų veikia įdiegtas modelis. Dažniausiai tai aktualu finansavimą pritraukusiam startuoliui arba jau veikiančiai įmonei su nedidele ML komanda.
Netinka ankstyvoje, dar produkto neturinčioje stadijoje
Jei vis dar ieškote modelio, kuris apskritai veiktų, kurti MLOps infrastruktūrą dar per anksti. Kol nepatvirtinta, kad modelis sukuria reikiamą rezultatą, užrašinė yra tinkamas darbo įrankis – MLOps diegimas šiame etape sukurtų struktūrą procesui, kurio dar nėra kam taikyti.
Neveikia be vidinės atsakomybės
Jei tikslas – tiesiog perduoti platformą neįtraukiant jūsų inžinierių, tokia praktika dažniausiai neišlieka pasibaigus projektui. Žinių perdavimas nėra atskiras projekto etapas – tai mechanizmas, leidžiantis sprendimui veikti ir toliau.
Valdymas – atskira darbų kryptis
Modelių kortelės, patvirtinimo etapai ir auditui skirti duomenų eksportai reguliuojamiems automatizuotiems sprendimams remiasi atkuriamumu, tačiau tai jau yra politikos ir valdymo, o ne infrastruktūros klausimai. Juos verta planuoti kaip atskirą darbų kryptį ir imtis tada, kai bazinis modelių istorijos registravimas jau veikia.
Kas lemia sėkmingą MLOps – ir kur dažniausiai procesas stringa
MLOps nėra vien įrankių įsigijimas. Svarbiausia – kokia tvarka sprendžiami atkuriamumo, matomumo ir automatizavimo klausimai, o daugelis komandų šią seką pasirenka neteisingai. MLOps taip pat turi nuolatinių sąnaudų: reikia inžinierių laiko, kaupiasi telemetrijos duomenys, o procesinės disciplinos negalima laikyti savaime suprantama – ją reikia nuosekliai palaikyti.
Pirmiausia – atkuriamumas
Jei negalite atkurti modelio, negalite jo kryptingai tobulinti. Kiekvienas pakartotinis mokymas tampa spėjimu, kas pasikeitė, o kiekviena regresija – ilgu tyrimu vietoje paprastos duomenų užklausos. Visa kita MLOps praktika remiasi būtent šia savybe.
Stebėsenai būtinas atskaitos taškas
Modelio nuokrypio signalas mažai ką reiškia, jei nėra įrašo, kokiais duomenimis modelis buvo mokytas ir kokius rodiklius tuo metu pasiekė. Atskaitos taškas yra stebėsenos pagrindas – be jo perspėjimai tampa tik sudėtingesne spėjimo forma, o sprendimai dėl pakartotinio mokymo priimami intuityviai.
Automatizavimas – tik trečias žingsnis
CI/CD procesas nuo kodo pakeitimo iki produkcinės aplinkos turėtų atsirasti tik užtikrinus atkuriamumą ir stebėseną. Automatizavus procesą, kurio dar negalima atkurti ar tinkamai stebėti, tiesiog greičiau sukuriami neatkuriami modeliai, o vėlesnis problemų tvarkymas tampa dar brangesnis.
Komanda turi pati valdyti procesą
MLOps sistema, kurios niekas organizacijos viduje nesupranta, dažniausiai neišgyvena pasibaigus projektui. Stebėsenos sistema naudinga tik tada, kai per ją pereina kiekvienas modelio mokymo paleidimas – užtenka vieno inžinieriaus, nusprendusio „tik šį kartą“ mokyti modelį lokaliai, kad grįžtų ta pati problema, kurią infrastruktūra turėjo pašalinti.